

NVIDIA Vera Rubin 正式登場,並邁向百萬瓩級規模。
Vera Rubin NVL72 正加速量產,合作夥伴 CoreWeave、Google Cloud、Microsoft Azure 與 Oracle Cloud Infrastructure 均已開始運行相關機架。Vera Rubin 的機架級供應鏈橫跨 30 個國家、逾 350 座工廠據點,規模與成熟度皆創歷來之最,可滿足客戶的運算需求。
Vera Rubin 平台從晶片到網格進行整體設計,以提供最高的每瓦效能與最低的詞元成本。CoreWeave 針對 DeepSeek-R1 進行的首次基準測試充分展現這項優勢:每百萬瓦的輸送量為 Grace Blackwell NVL72 的 10 倍,直接改善電力受限人工智慧(AI)工廠最重要的指標。
透過極致協同設計推進效能
實現這一切的關鍵在於橫跨七款晶片與五種機櫃托盤的極致共同設計,包括 Vera Rubin NVL72、Vera CPU 機架、Groq 3 LPX、Spectrum-6 SPX 與 Vera BlueField-4 STX。這些元件以單一系統為目標進行設計,而非由各自獨立的市售現成產品組裝而成。
NVIDIA Vera CPU 是整套系統的核心,重新定義 AI 工廠 CPU。這款專為代理時代設計與打造的處理器,其客製化的 Olympus 核心相較於競爭對手的小晶片(chiplet)設計,單執行緒效能提升 2 倍、核心間頻寬提升 3 倍,並將記憶體延遲降低 40%,使其成為處理最重要代理型工作負載時,效率最高的單執行緒 CPU。
以專為需求打造的網路加速 AI 工廠
在網路方面,該平台採用第六代 NVLink 垂直擴展技術,相較於市售乙太網路,在處理複雜工作負載的輸送量提升超過 2 倍,延遲降低 3 倍,封包速率則提升 10 倍。在橫向擴展方面,Spectrum-X 乙太網路整合 102.4T Spectrum-6 交換器系統、1.6T ConnectX-9 SuperNIC、自適應路由、進階壅塞控制、遙測功能與開放式作業系統支援,使其 RDMA 頻寬較市售乙太網路高出 1.6 倍。
CoreWeave、微軟、SpaceXAI 與 Tesla 等全球頂尖 AI 基礎設置建構商,皆率先導入 Spectrum-6 交換器,以加速其 AI 工廠。用於橫向擴展且採用共同封裝光學元件的 NVIDIA Photonics,是業界首款進入量產的此類交換器。相較於可插拔收發器,其功耗降低 5 倍,平均故障間隔時間(MTBI)提高 10 倍,CoreWeave、Lambda 與 OCI 均為首批採用者。
Spectrum-XGS 乙太網路透過 1.9 倍的多站點輸送量,將效能延伸至不同站點,因為百萬瓩級 AI 無法只靠單一設施實現。
NVLink Fusion 則向第三方 XPU 開放 NVIDIA 基礎設施平台,讓合作夥伴可透過經過驗證的 NVLink 垂直擴展技術堆疊與生態系,更快將產品推向市場。
節省組裝時間與用水
NVIDIA 經過三代機架級協同設計,打造出托盤內沒有任何纜線、風扇或軟管的 Vera Rubin NVL72 系統,讓運算托盤組裝時間從數小時縮短至 1 分鐘。
攝氏 45 度的液冷進水溫度設計,使系統能夠在無需冷卻機的情況下,直接採用乾式冷卻運作。對於新建的 AI 工廠而言,這種高溫乾式冷卻技術搭配閉迴路液冷系統,每部署 1 百萬瓦,每年可節省數百萬加侖用水。
NVIDIA Vera Rubin 驅動歐洲開放模型時代

Vera Rubin 正為歐洲 AI 基礎設施帶來新一代效能。
Vera Rubin 是微軟與 Mistral 擴大合作的基礎。這項合作將前沿 AI 帶入歐洲,結合開放式的歐洲模型、雲端環境與客戶自主控制的環境,讓政府與受監管產業能依自身需求採用這些技術。
這項合作以一項聚焦擴充歐洲 AI 基礎設施、價值數十億美元的全新協議為基礎。Mistral 正透過採用數千顆最新的 NVIDIA Vera Rubin GPU 來擴充其 GPU 容量,以提高客戶可用的 AI 運算資源,並提供一個用於訓練、推論與大規模部署的共享平台。
NVIDIA Vera Rubin 正加速進入全面量產。這款機架級 AI 超級電腦將七款協同設計的全新晶片整合為單一系統,並將以數萬顆 GPU 驅動下一代 Mistral Compute 與微軟的歐洲 AI 基礎設施。
歐洲希望全球最強大的 AI,且能依其自身法規運作、在本地營運,並完全掌握控制權。而標準正不斷提高:代理型系統的詞元消耗量最高可達傳統 AI 應用的 15 倍,這使得高效率的基礎設施成為策略重點。要滿足這項期待,不能只靠運算容量,還需要可高效擴展的 AI,同時符合區域對資料控制、治理、韌性與策略自主性的要求。
Vera Rubin 為歐洲開放模型生態系提供運算基礎。其全端架構結合加速運算、網路與軟體,讓模型與代理從訓練到正式環境部署都能高效運行。
專為企業 AI 打造的開放模型
微軟、Mistral 與 NVIDIA 共同在公有雲,以及與雲端連線和完全離線的私有雲環境中,提供符合主權要求的 AI 解決方案,將開放式模型的彈性與大規模運作所需的基礎設施相結合。
Mistral Medium 3.5 與 OCR 4 現已在 Microsoft Foundry 上提供,Mistral 模型也已整合至 Microsoft Copilot Studio。透過 Azure Local 與 Foundry Local,客戶可在雲端與自主控制的環境中,使用相同的模型、工具與操作模式。
符合歐洲規範的 AI
政府機構可將 AI 應用於敏感工作流程。醫療保健與金融服務機構可依區域規範進行部署。製造商則可在現場處理資料,加快決策速度。相較於 NVIDIA GB200 NVL72,Vera Rubin NVL72 每百萬瓦可產生的詞元最高提升 10 倍,每百萬詞元成本降至十分之一,並可在相同電力消耗下提供更多智慧。
主權 AI 不應迫使組織在創新、經濟效益與控制權之間做出取捨。以 Vera Rubin 作為運算基礎,再加上微軟與 Mistral 提供的主權雲端基礎設施及開放的歐洲模型,歐洲便能同時實現這三項目標。
更多資訊請參閱 Microsoft 與 Mistral 的新聞稿。
CoreWeave 上的 NVIDIA Vera Rubin NVL72 在基準測試中,
每百萬瓦產生的詞元數較 Blackwell 提升 10 倍

CoreWeave 與 NVIDIA 採用極致協同設計,讓 Vera Rubin NVL72 實現數量級的效能躍進。
與 CoreWeave 等合作夥伴緊密合作,對於將新一代 NVIDIA 加速運算導入 AI 工廠而言至關重要。
經過數月的共同工程開發,CoreWeave 成為首家啟用並驗證 Vera Rubin NVL72 的 AI 雲端業者,如今也公布首批由實際硬體測得的效能資料。
CoreWeave 在 Vera Rubin NVL72 上執行了 DeepSeek-R1 基準測試,結果顯示其在每百萬瓦下每秒產生的詞元數,相較於 Grace Blackwell NVL72 提升 10 倍。
每百萬瓦詞元數是決定 AI 基礎設施能否以具經濟效益之方式擴展的關鍵指標。每百萬瓦可產生更多詞元,代表能在相同的電力預算下能產生更多智慧,或以大幅更低的電力執行相同的工作負載。包括 Jane Street 在內的 AI 實驗室與企業,將利用 Vera Rubin 平台在 CoreWeave 雲端上擴展其 AI 工廠。
以 NVIDIA Spectrum-X 突破瓶頸
DeepSeek R1 採用混合專家(MoE)架構,使 GPU 全互連通訊成為大規模運作的關鍵需求。每個詞元都必須在分散式的專家子網路之間進行路由。Vera Rubin NVL72 的 260 TB/s 全互連 NVLink 6 網路架構,消除了這項限制,讓整個機架作為單一的整合式加速器來運作。
CoreWeave 是首批將 NVIDIA Spectrum-X 乙太網路 SN6600-LD 部署為 Vera Rubin NVL72 交換網路架構的業者之一。
CoreWeave 基於 102.4 Tb/s 的 Spectrum-6 交換器晶片,並採用液冷設計,部署了高密度交換器機架。每機架可提供 1.64 Pb/s,容量較前代氣冷交換器提高 100%。CoreWeave 也提供完全無阻塞、多平面、多軌的主幹枝葉式架構(spine and leaf fabric),在無需超額訂閱的情況下連接 Vera Rubin NVL72 GPU。
NVIDIA Vera Rubin NVL72 驅動 Google Cloud 全新 A5X 執行個體,為 Ineffable Intelligence 提供支援
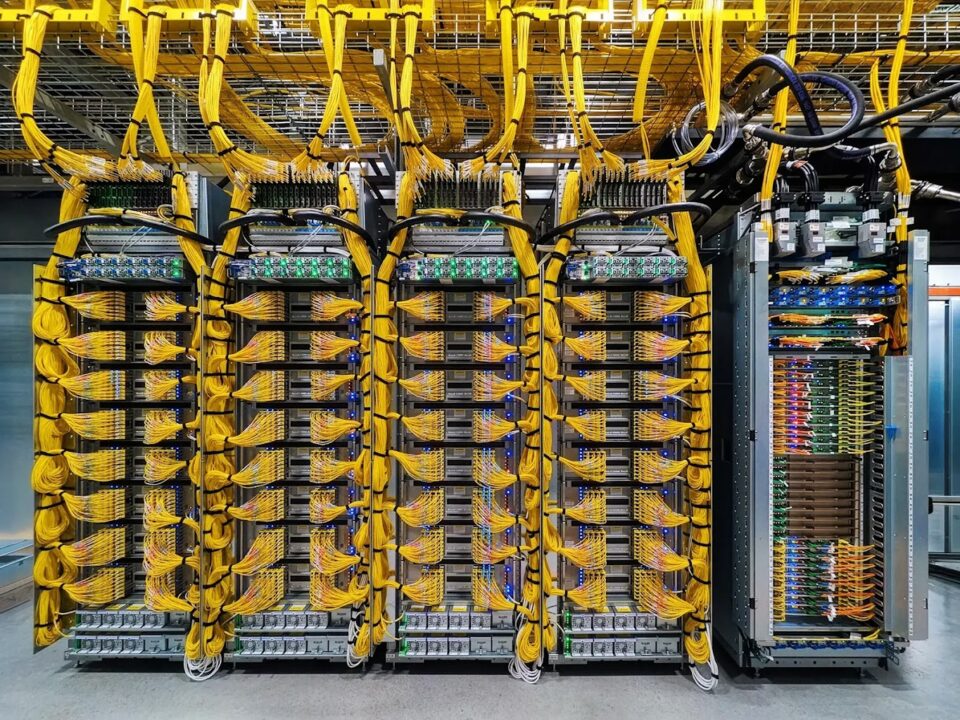
NVIDIA Vera Rubin NVL72 正在驅動 Google Cloud 首款 A5X 執行個體,該執行個體獲倫敦新創公司 Ineffable Intelligence 採用,並已投入運作。
Ineffable Intelligence 致力於開發新一代智慧型「超級學習者(superlearner)」系統,該系統能透過經驗持續學習,推動各領域的全新突破。
Ineffable Intelligence 的代理直接透過與環境的互動來學習,而非仰賴靜態資料集。該公司並未採用大型語言模型,而是透過強化學習開發「超級學習者」系統,在持續模擬的大規模平行環境中產生經驗,並迅速將這些經驗轉化為策略更新與評估。這些緊密耦合的學習迴圈對運算能力、記憶體頻寬與互連技術提出極高要求,需要能夠在極大規模下運作且具備極低延遲的基礎設施。
Ineffable Intelligence 共同創辦人 Lasse Espeholt 表示:「下一代研究需要下個世代的硬體。我們很榮幸能與 NVIDIA 和 Google Cloud 團隊合作,並能率先開始使用 Vera Rubin。兩個團隊提供的支援無可比擬,我們幾乎立即完成系統啟用,目前已開始為超級學習者測試基礎設施。」
NVIDIA Vera Rubin NVL72 專為這類代理型訓練設計,不僅能提供可預期的延遲與高利用率,其每美元所提供的智慧產出更遠高於前代系統,因此成為大規模強化學習的理想平台選擇。
在 Google Cloud Next 上發表的 Google Cloud A5X 執行個體,是以 NVIDIA Vera Rubin NVL72 機架級系統打造的裸機執行個體。相較前代,其每詞元推論成本最高降至十分之一,每百萬瓦詞元輸送量最高提升 10 倍。
A5X 結合 NVIDIA ConnectX-9 SuperNIC 與新一代 Google Virgo 網路,讓叢集在單一站點內可擴展至數萬顆 NVIDIA Rubin GPU,多站點配置則最多可擴展至近 100 萬顆 GPU。客戶可藉此取得統一且針對 AI 最佳化的技術堆疊,用於訓練、調校與服務前沿、開放、代理型及物理 AI 模型,同時最佳化效能、成本與永續性。
這項基礎設施旨在協助釋放新一代強化學習系統的潛力,推動超級學習與超級智慧的突破。
NVIDIA Vera CPU 將 DeepInfra AI 雲端的協調速度提升一倍

DeepInfra 的基準測試結果顯示,相較於其他 CPU,NVIDIA Vera CPU 的運算速度超過 2 倍,並能支援更多並行運作的 AI 代理。
雲端平台 DeepInfra 作為 NVIDIA 開放 AI 生態系的早期參與合作夥伴,使用其生產級 AI 代理基礎設施,獨立設計及執行基準測試。DeepInfra 每週處理近 5 兆個詞元,其中約 30% 由代理型系統驅動,其雲端平台專為高輸送量 AI 推論打造。
基準測試顯示,在維持相同服務品質的情況下,Vera CPU 可支援多達 1.6 倍的並行 AI 代理,協調速度最高達其他 CPU 的 2.2 倍,同時提升基礎設施利用率與成本效益。這些結果顯示,NVIDIA Vera CPU 具備生產級代理型 AI 所需要的成本效益、低延遲與輸送量。
隨著 AI 代理承擔更複雜的推理、規劃、工具使用與資料移動任務,CPU 效能在協調每次模型呼叫前後的工作流程已變得愈發重要。
作為 NVIDIA AI 工廠極致協同設計策略的一部分,Vera CPU 專為代理型工作負載打造。DeepInfra 的基準測試凸顯了 NVIDIA Vera CPU 如何協助雲端服務供應商提升基礎設施利用率、增加成本效益,並在相同服務品質下支援更多並行 AI 代理。
深入了解 NVIDIA Vera Rubin 平台。