
AI 工廠的建置規模以百萬瓦、甚至百萬瓩計。每座百萬瓦級工廠的成本約為 6,000 萬美元,AI 工廠營運商唯有在能清楚掌握投資報酬的情況下,才會投入如此龐大的資本。影響 AI 工廠報酬的三大關鍵因素包括:
- 獲利能力:若工廠售出其所能產生的每個詞元 (token),一年可創造多少收益。
- 使用壽命:AI 硬體能持續創造收益多久。
- 需求:市場對這些詞元有多少需求。
其中一項因素表現強勁,並無法完全抵銷另一項因素的弱勢。如果工廠只能售出部分產能,強大的獲利能力便難以發揮價值;如果工廠短短一年後便無法再以滿載的產能運作,再高的需求也無濟於事。這三項因素也並非彼此獨立。能執行更多種類工作負載的工廠,可觸及更多需求,進而年復一年持續創造收益。
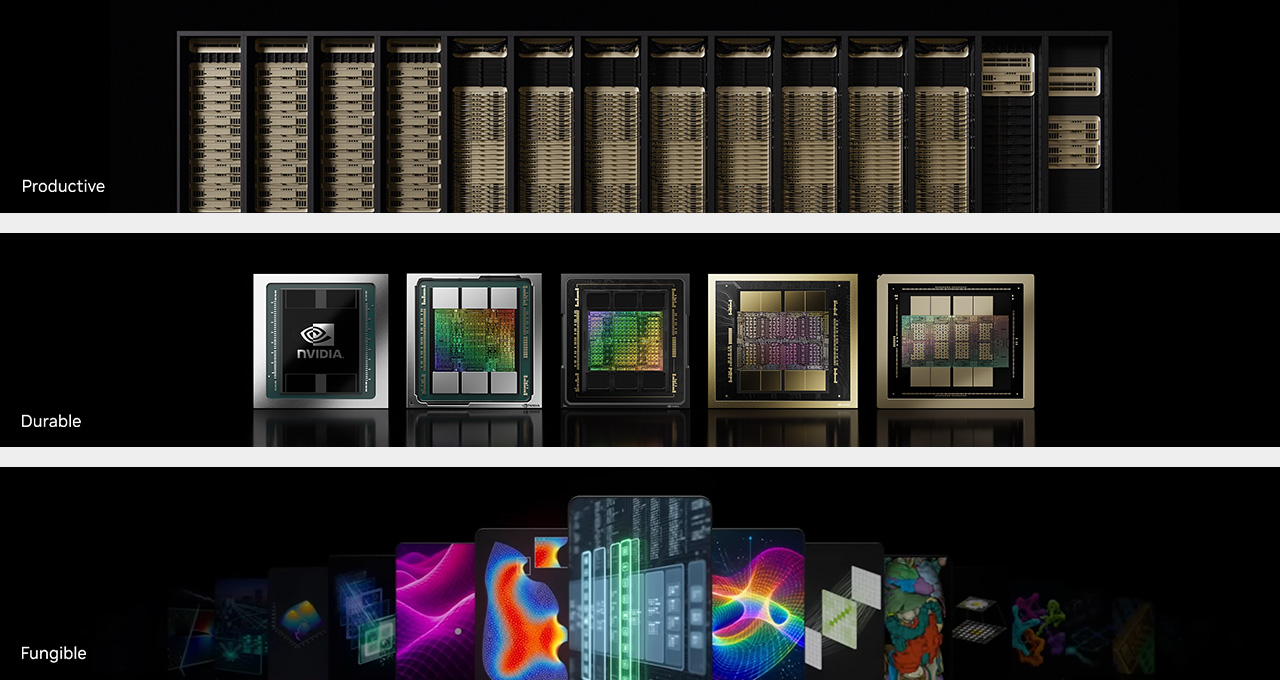
NVIDIA AI 工廠經過精心設計,能將這三項因素發揮到極致,具備以下特性:
- 高生產力:提供每百萬瓦最高的吞吐量與最低的單一詞元成本,進而提升獲利能力。
- 持久耐用:NVIDIA GPU 與系統在出貨多年後仍能持續創造收益,延長使用壽命。
- 靈活通用:可在各個階段與各種環境中執行所有類型的 AI,以及許多完全不涉及 AI 的工作負載,進而深化並擴大可服務的需求。
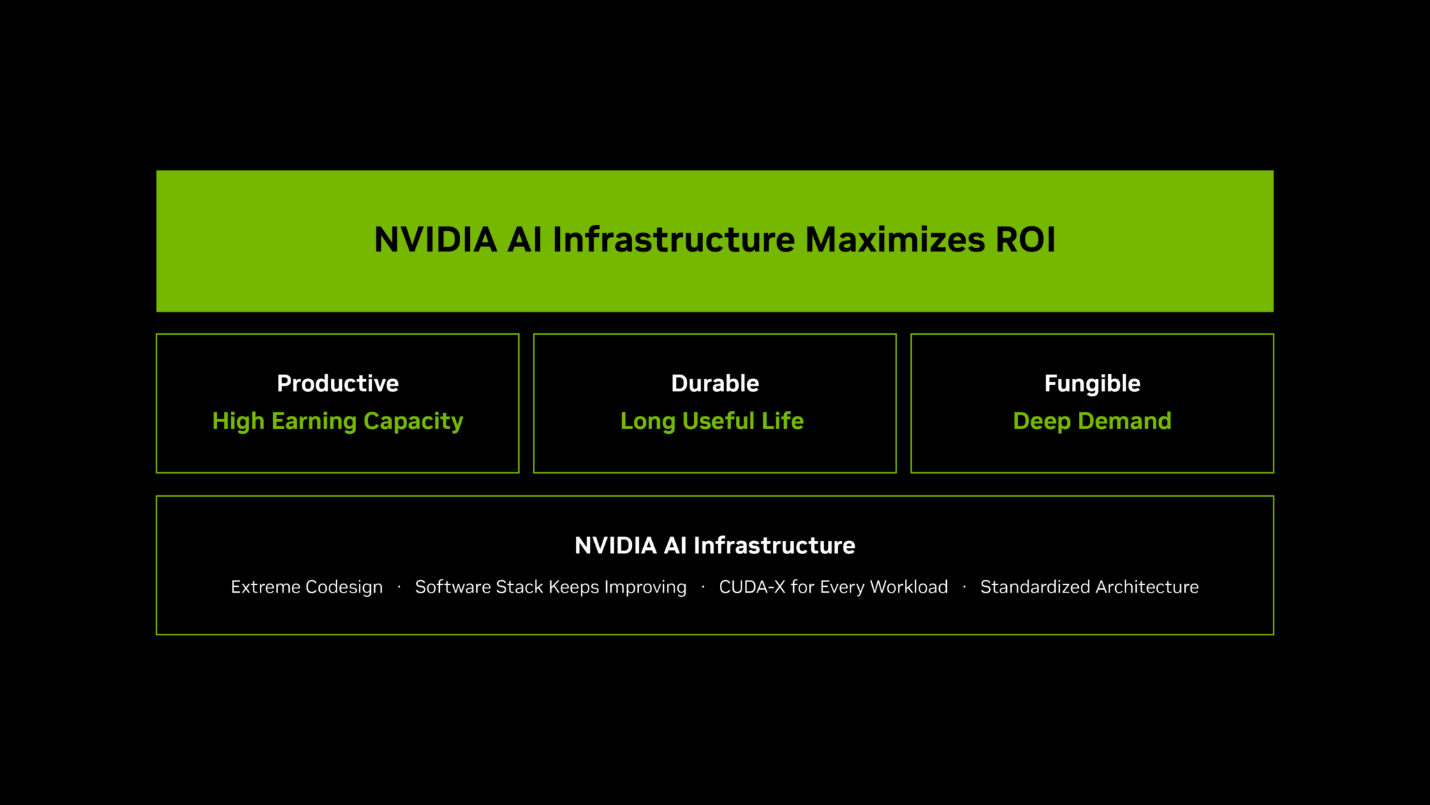
涵蓋完整堆疊的協同設計可提升 AI 工廠的吞吐量,而持續進行軟體最佳化,則能讓已部署的硬體在出貨多年後仍維持高生產力。NVIDIA CUDA-X 函式庫讓工廠得以執行任何加速工作負載;標準化架構則讓所有營運商都能運用這些能力,並透過經過驗證的參考設計加以部署。
高生產力:每百萬瓦最高詞元產量與最低詞元成本
電力是 AI 工廠最關鍵的限制因素,因此每百萬瓦每秒可產生的詞元數量,便成為決定獲利能力的指標。在固定功率範圍內產生更多詞元,代表能創造更多營收;降低每個詞元的成本,則代表能提高利潤。
SemiAnalysis AgentX 的資料顯示,在 DeepSeek V4 Pro 模型上,NVIDIA Vera Rubin NVL72 系統每百萬瓦的吞吐量比 NVIDIA GB300 NVL72 高出逾 30 倍,每百萬個詞元的成本更可降低達 45 倍。如此大幅的提升,來自涵蓋全端的極致協同設計:從模型與工作負載,到軟體、運算、網路及記憶體,各個層面皆經過整體最佳化。
這帶來兩個問題。若每一代系統都能大幅降低詞元成本,運算需求是否會因此縮減?
不會,需求反而會擴大。
成本更低的詞元能讓更多應用案例具備經濟效益,而這些應用案例消耗的詞元數量,將超過效率提升所節省的數量。
第二個問題則與耐用性有關。既然每一代系統都遠勝前一代,舊世代系統將何去何從?
持久耐用:既有安裝基礎持續創造收益
並非所有工作負載都需要最新系統。最適合的系統取決於工作負載的複雜度與型態,因此新一代系統問世後,前一代系統仍能持續創造收益。
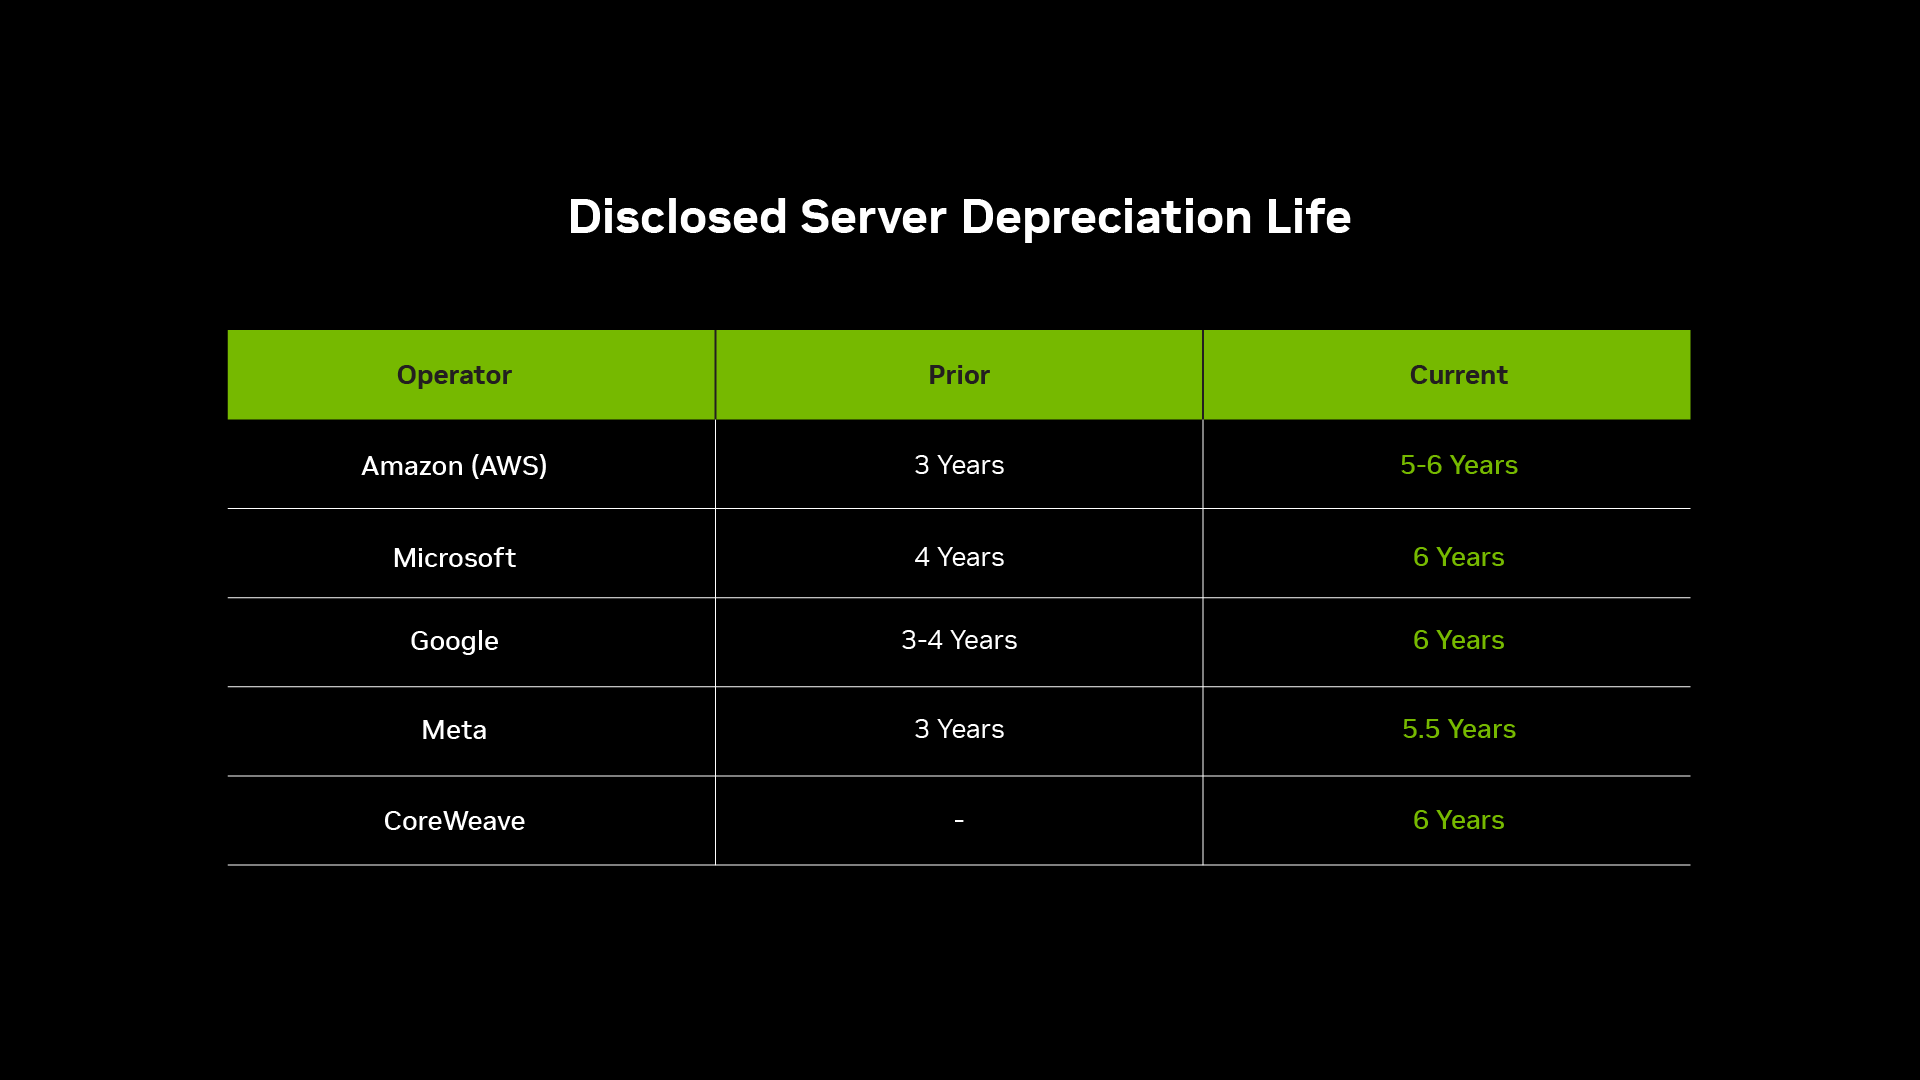
NVIDIA A100 GPU 於 2020 年出貨,六年後仍投入商業服務,展現持續創造經濟價值的能力;CoreWeave 最近更將 2020 年首度推出之設備的預訂合約延長至 2029 年。多年來,各大營運商皆延長伺服器的折舊年限。折舊年限原本是對硬體何時停止創造收益的推估,但這個時間點不斷往後延。Sprout 於 2026 年 9 月發布的分析報告《資料中心 GPU 的生產力壽命》,追蹤了各大營運商折舊年限的變化。
Barkr 根據系統的轉售價值,估計八張 H100 GPU 系統的使用壽命為五至六年,GB300 NVL72 則為九至十年。Silicon Data 的資料顯示,使用六年的 A100 GPU 仍保有原始成本四分之一的價值;若依五年折舊年限計算,它在一年多前的帳面價值便已歸零。Ornn Data 則發現,市場對 A100 GPU 五年租約的租金,仍願意支付相當於一個月租約租金的 80%。
用於程式設計 NVIDIA GPU 的軟體平台 CUDA 可跨世代運作,因此新架構問世時,營運商既有的任何設備都不會淪為閒置資產。持續進行軟體與核心最佳化,也能不斷提升既有硬體的能力。
同一套平台可執行機器學習、深度學習、生成式 AI、推理、代理式 AI 與物理 AI。每一種新型態的工作,都能在已安裝的硬體上運作。
這就是靈活通用。系統能承接的工作種類越多,就越能持續找到工作並創造收益。
靈活通用:各類型 AI、各階段、各環境皆可運行
只為單一工作類型打造工廠,等同押注該工作將持續存在。能執行所有工作負載的工廠,即使工作內容發生變化,仍可持續發揮效用並創造營收。
NVIDIA AI 工廠可執行語言、視覺、生物學、物理與機器人等領域的各類 AI 模型,包括開放式與專有模型;也能支援從資料處理、預訓練、後訓練到推論的所有階段,並可部署於各種環境,從超大規模與 AI 雲端、主權 AI 計畫、企業資料中心一路延伸至邊緣。
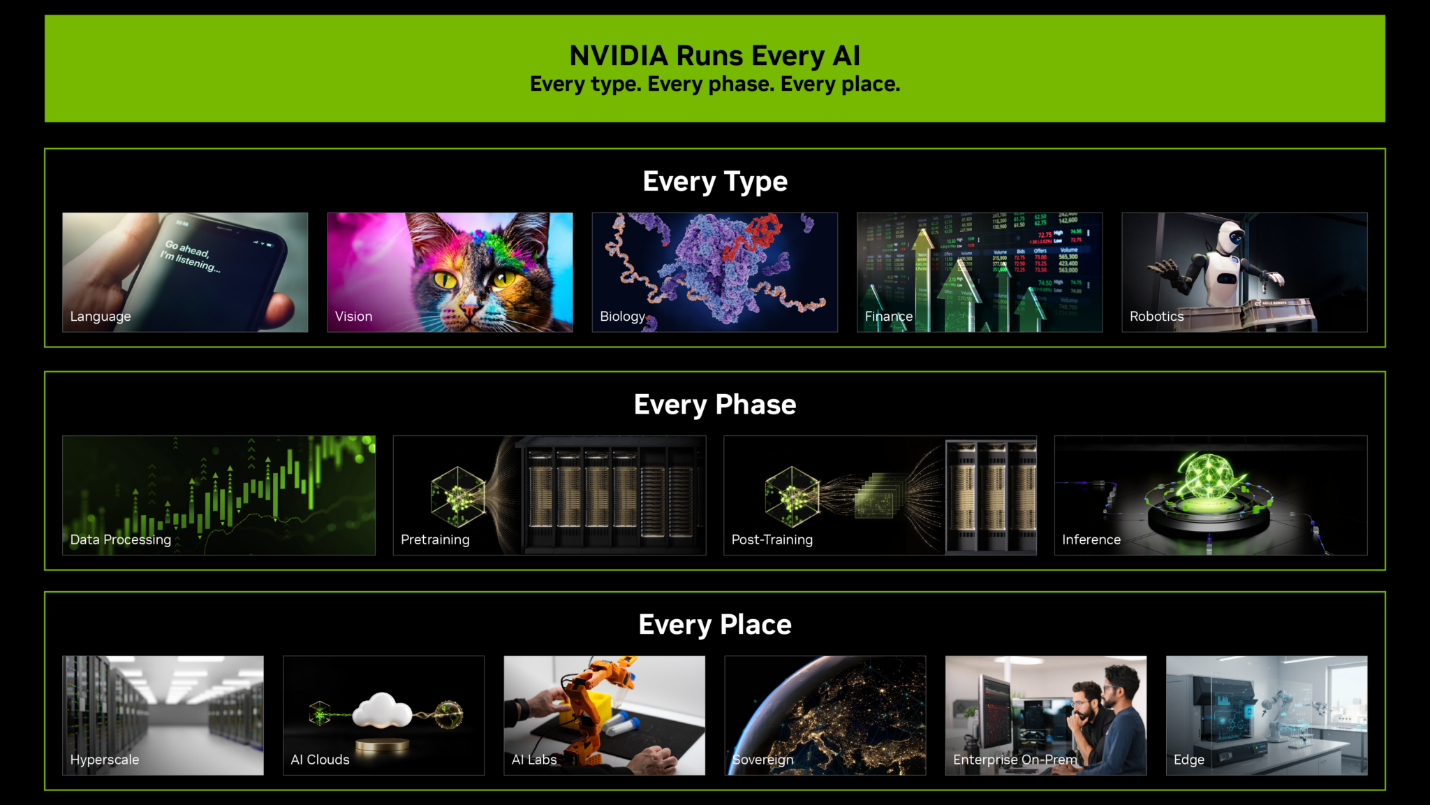
其中並非全都用於建構與執行 AI 模型。同一套基礎架構也能執行資料處理、科學運算、模擬、圖形處理等工作。
上述所有 AI 與非 AI 工作負載,最終都可歸結為相同的平行運算,而 NVIDIA GPU 正是為在數千個核心上同步執行這類運算而打造。CUDA 讓單一晶片既能模擬光線、摺疊蛋白質,也能預測下一個詞元。其上更有超過 1,000 個現成可用的 CUDA-X 函式庫與模型,涵蓋深度神經網路、運算微影、量子電路模擬、向量搜尋與氣候建模等各種領域,並吸引超過 1,000 萬名開發者投入建構。
這正是 NVIDIA GPU 屬於通用加速運算平台,而非只為單一工作負載打造的客製化 ASIC 的原因。通用不代表泛用而缺乏專長:Tensor Core 與 Transformer Engine 將針對 AI 最佳化的硬體整合至可程式化架構,在單一晶片中兼具專業效能與彈性。由單一架構執行所有工作負載,正是維持高使用率與高報酬的關鍵。
這種多功能性已在眾多客戶的正式環境中展現:
- Lilly:在內部部署、配備 1,016 顆 GPU 的叢集上建構並執行蛋白質、小分子與基因體模型,並為內部團隊提供聊天機器人及代理式工作流程。
- Pinterest:在超大規模雲端上,使用橫跨 NVIDIA Blackwell、Hopper 與更早期架構的 14,000 顆 GPU,對視覺語言模型進行後訓練與部署。
- Revolut:使用 NVIDIA cuDF 處理數十億筆交易紀錄的資料,接著在 AI 雲端上訓練及部署基礎模型。
- Runway:在 NVIDIA Hopper 上訓練世界模型,並透過雲端基礎架構在 NVIDIA Blackwell 平台上提供服務。
- 德州農工大學:在超級電腦上執行分子模擬與 AI 藥物探索,支援 26 項專案與七所機構,使用率達 95% 至 98%。
AI 之外的領域亦是如此。Cosm 營運由 NVIDIA 技術驅動的分散式資料中心,為高解析度影片播放、串流、即時圖形與同步顯示提供彈性運算資源。Dassault Systèmes 則為 Wichita State 的飛機認證,以及 Lucid Motors 的車輛設計提供虛擬孿生模擬技術。Unilever 也不再依賴實景拍攝,而是運用數位孿生製作產品影像,將製作成本減半。
這裡不可能列出所有案例,而這也正是重點所在。
NVIDIA AI 工廠經過精心設計,具備高生產力、持久耐用與靈活通用等特性,可創造利潤更高的詞元、延長使用壽命並擴大需求,進而實現投資報酬最大化。
持續關注並收看 NVIDIA 創辦人暨執行長黃仁勳的 GTC Berlin 主題演講,深入了解 NVIDIA AI 工廠。