
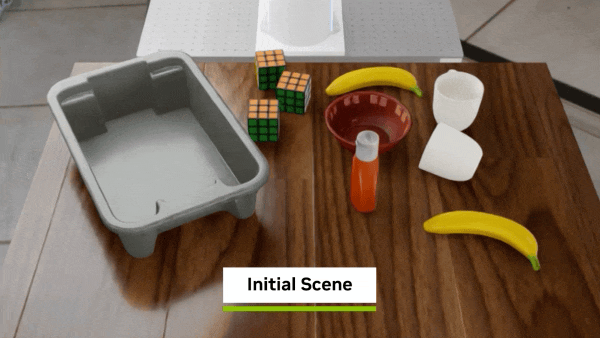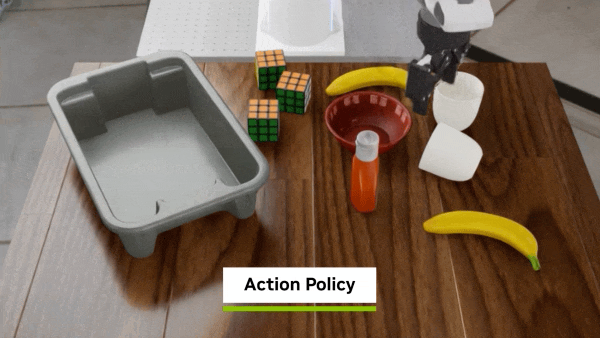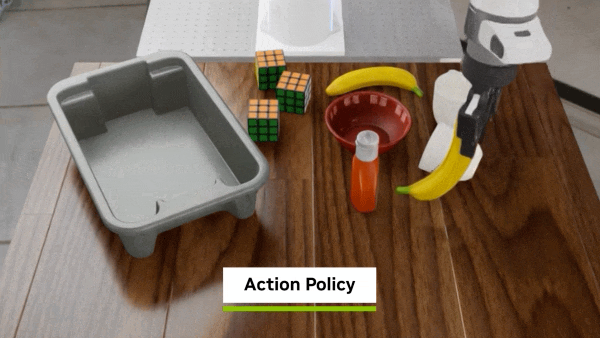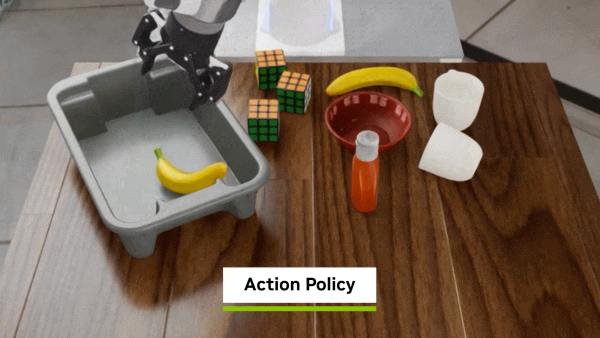
機器人領域的一項核心挑戰,是打造能將能力泛化到訓練示範之外的策略。在訓練場景中成功的策略,往往會在物件形狀、位置或光線改變時失效。要泛化至這些新條件,策略必須理解任務背後的物理原理,而不只是模仿示範。這項能力取決於策略所採用的骨幹模型。
建構語言條件式機器人策略的標準方法,是在預訓練的視覺語言模型 (vision-language model,VLM) 上加入動作模組,形成視覺-語言-動作 (vision-language-action,VLA) 模型。這種方法已大幅推進通用型操控能力。然而,VLM 骨幹學到的是描述世界,而不是預測世界如何演變。當任務需要預判場景將如何變化時,機器人缺少的正是這種動態模型。日益增多的研究改以影片世界模型取代語言骨幹,形成世界行動模型 (world action model,WAM)。NVIDIA 研究員 Jim Fan 在「Robotics’ End Game」演講中探討了這項轉變,之後有人將這個概念概括為「VLA 已死,世界行動模型萬歲。」
本文探討後訓練如何將 WAM 轉變為專用機器人策略、WAM 與 VLA 的差異,以及開放式 NVIDIA Cosmos 3 世界模型為何能成為建構 WAM 的堅實基礎。
現今如何打造後訓練策略
在 VLA 架構中,預訓練 VLM 負責理解場景語意與語言指令,後訓練則學習如何將這些理解對應至機器人動作。現代通用型機器人策略日益以這種方法為基礎。
然而,VLM 的最佳化目標是針對影像生成文字,而非模擬場景將如何演變。它不會學到夾爪閉合時杯子會發生什麼變化、毛巾如何摺疊,或物件釋放後會落在何處。VLA 具備良好的語意泛化能力,但由於其骨幹模擬的是語言與感知,而非世界動態,因此對未曾見過的行為與環境,物理泛化能力較為有限。
WAM 帶來哪些改變
WAM 透過以影片世界模型作為策略基礎,突破動態建模的限制。由於骨幹模型會模擬世界如何演變,後訓練無須從零開始教授動態,而是將已具備物理先驗知識的模型進行專業化調整。NVIDIA 研究論文「世界動作模型即零樣本策略」顯示,同時預測影片與動作,可讓策略獲得 VLA 難以取得的特性:
- 能從多元資料中學習。VLA 學習將指令對應至軌跡,通常需要針對同一任務提供幾乎完全相同的示範。WAM 則學習物理原理,例如物件在被推動、抓取或放下時如何移動。任何互動資料都能提供學習訊號。對 VLA 而言可能派不上用場的多元資料集,對 WAM 卻能成為訓練訊號,並降低資料蒐集成本。
- 能在開放世界中泛化。物理原理比語意更具普遍性。物件掉落或滑動的方式不會因物件種類而改變,因此學會動態的模型,可以將這些知識運用到未曾接受訓練的場景與動作中。
- 只需少量示範即可適應新機器人。已理解物理互動的模型,只需要少量特定任務資料,就能專業化調整至新的機械手臂或夾爪。
對建構策略的團隊而言,這些優勢相當實際:以更少資料達到指定能力、在訓練分布之外展現更佳行為,並縮短適應新機器人形態的時間。這些都是預訓練骨幹本身的特性,因此會反映在以其為基礎進行後訓練的每項策略中。
Cosmos 3 是強大的 WAM 基礎
Cosmos 3 是採用全能模型世界基礎模型,以混合 Transformer (Mixture-of-Transformers,MoT) 架構打造。多模態輸入會先流經自迴歸 transformer 進行推理,產生文字等離散 token,再引導擴散 transformer 處理影像、影片、音訊與動作等連續模態。文字透過下一個 token 解碼生成;其他內容 (包括動作) 則透過反覆去雜訊合成。單一模型可涵蓋這些模態,同時為各模態保留最合適的生成機制。Cosmos 3 提供三種規模:4B 的 NVIDIA Cosmos Edge、16B 的 NVIDIA Cosmos Nano,以及 64B 的 NVIDIA Cosmos 3 Super。
Cosmos 3 能成為後訓練強大基礎的關鍵,在於其物理世界資料的廣度。資料集包含約 7.67 億張影像、3.48 億段真實世界動態影片,以及 800 萬筆動作樣本,涵蓋機器人操控、自動駕駛、攝影機運動與第一人稱運動。
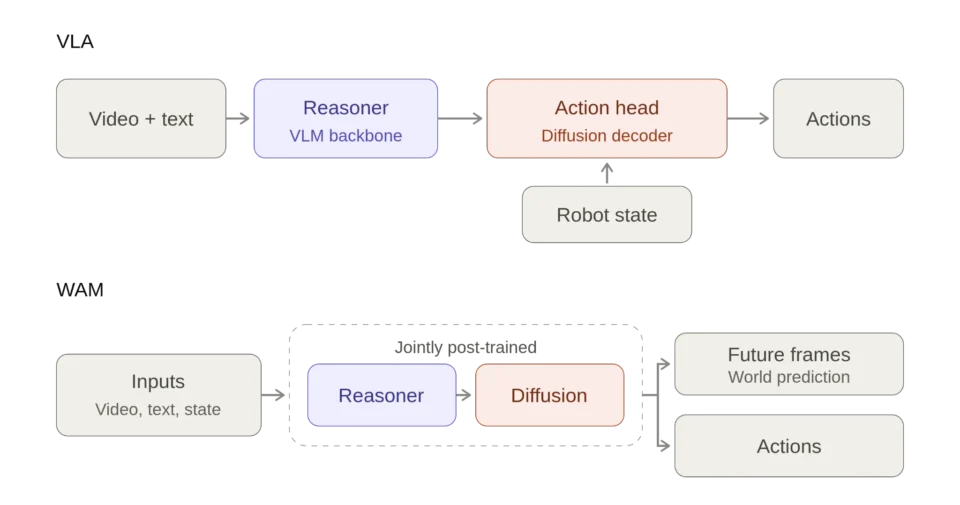
圖 1:VLA 根據語意推理與機器人狀態生成機器人動作,而 WAM 則同時預測動作與未來世界狀態
從世界模型到機器人策略:Cosmos 3 Policy DROID 模型
Cosmos 3 是專業化調整的起點。Cosmos3-Nano-Policy-DROID 是以 Cosmos 3 Nano 為基礎,針對 DROID 平台進行後訓練的 16B 參數策略。DROID 平台由 Franka Panda 機械手臂搭配 Robotiq 夾爪組成。4B 版本 Cosmos3-Edge-Policy-DROID 以相同方式進行後訓練,可用於裝置端部署。模型接收語言指令與多攝影機觀測後,會生成機器人動作軌跡。其全能模型基礎帶來三項特性:
- 在行動的同時進行想像。模型輸出動作時,也能輸出影片,呈現執行這些動作後機器人攝影機將看到的畫面。動作與預測結果由同一個模型同步產生。
- 保留完整的全能模型架構。後訓練不會移除任何能力。策略檢查點仍能進行推理與生成影片,而不只是輸出關節位置。
- 先驗知識的效益可量化。Cosmos 3 技術報告比較了兩項採用相同訓練方法、資料與運算資源的 DROID 策略。其中一項從基礎檢查點開始,另一項則從以多領域動作資料訓練的全能模型檢查點開始。全能模型檢查點將 RoboLab 成功率從 28.1% 提升至 36.8%。這明確證明改善來自架構,而不只是模型規模。
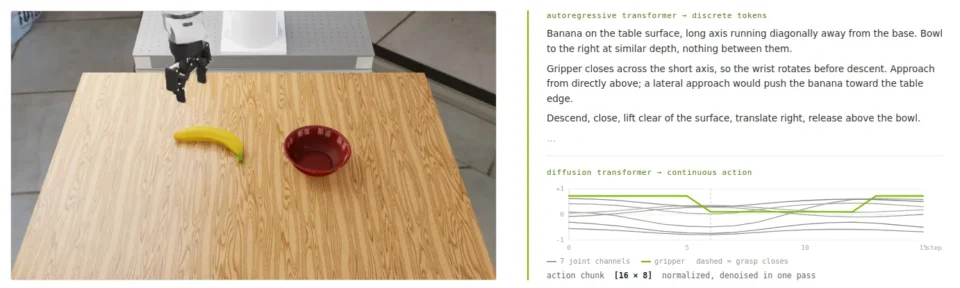
圖 2:機器人觀察桌上的香蕉 (左);模型預測的行動計畫以文字顯示
部署考量
WAM 搭載完整的生成式世界模型,而不只是動作頭。其規模比精簡型 VLA 更大,但 Cosmos 3 可對應不同部署層級,無須被迫取捨只能選擇單一方案:
- 工作站服務 (Nano,16B)。Cosmos3-Nano-Policy 並非在機器人內部執行,而是在機器人旁的工作站上運作。實際的 DROID 部署使用單張 NVIDIA RTX PRO 6000 提供模型服務,機器人透過網路串流觀測資料,並接收分段動作指令。
- 裝置端 (Edge,4B)。Cosmos 3 Edge 直接在嵌入式硬體上執行相同的策略工作負載。它以機器人控制解析度 (640 x 360 觀測畫面) 運作,在 NVIDIA Jetson Thor 上每次推論生成 32 個動作,並以 15 Hz 達到即時控制。此模型支援多種 NVIDIA 邊緣運算裝置,包括 RTX PRO GPU、DGX、GeForce RTX GPU 與 Jetson,以及全新的 Jetson T2000 與 T3000 模組。
為何使用 Cosmos 3 建構機器人策略?
WAM 代表一項轉變:從學習如何行動,轉向學習世界如何演變。Cosmos 3 讓這種方法得以實際應用:
- 開放基礎,最先進的起點。基礎模型、資料集、後訓練方法、訓練權重、評估工具與服務堆疊,皆依允許商業用途的授權條款發布。
- 更快速地適應。強大的物理先驗知識可減少新策略所需的特定任務資料。將資料轉換成機器人學習生態系已採用的 LeRobotDataset 格式,再執行已發布的訓練方法。
- 單一基礎,支援多種機器人。Franka、雙臂配置、UR、WidowX 等每種新機器人形態,仍需要各自進行後訓練。但它們都能從相同的預訓練基礎開始,無須從零預訓練世界模型,進而減少各種機器人所需的示範數量。
立即開始
評估 WAM 是否優於目前 VLA 的最快方式,是使用自有資料,以 Cosmos 3 為基礎進行後訓練並加以比較。
- 在 Hugging Face 與 GitHub 上探索開放式 Cosmos 3 模型系列與資料集。
- 閱讀 Cosmos 3 技術報告,深入了解完整架構細節與評估結果。
- 收看 Cosmos Labs 直播。
- 加入社群與 Cosmos Discord 頻道。