
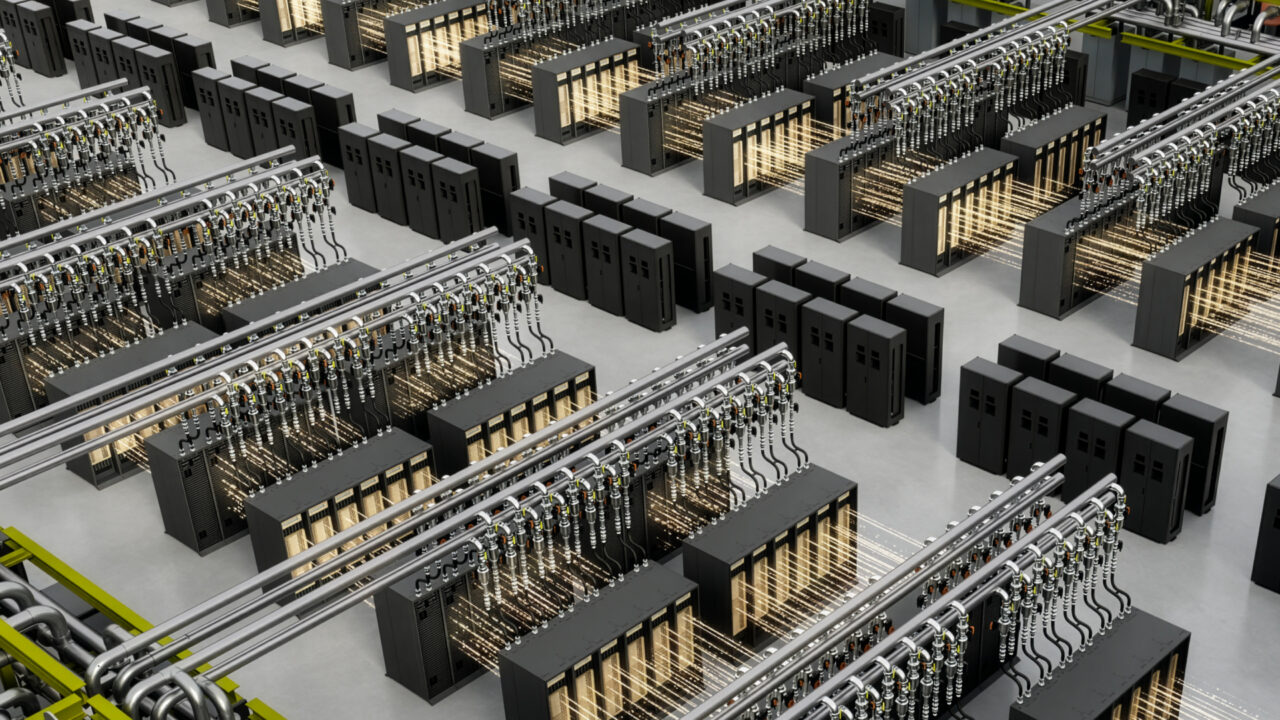
隨著 AI 工廠規模從百萬瓦(MW)邁向十億瓦(GW)等級,其建置需求已超越先進運算技術本身。開放標準正協助產業以更快速、更有效率且更可靠的方式擴展 AI 基礎設施。
在美國聖荷西 McEnery 會議中心舉行的開放運算計畫全球峰會(Open Compute Project Global Summit)上,NVIDIA 宣布多項全新合作與技術貢獻,以建立下一代 AI 基礎設施的共同基礎。
NVIDIA 透過 NVIDIA MGX 開放式架構,向開放運算計畫(Open Compute Project,OCP)貢獻 NVIDIA Vera Rubin 機櫃與運算托盤(compute tray)的關鍵設計,為系統建置業者提供共同基礎,以開發下一代 AI 工廠基礎設施。
這些共同合作與技術貢獻涵蓋 AI 工廠本身、為其供電的公用電網,以及作為現代加速運算核心的機櫃級架構。
NVIDIA 與合作夥伴宣布開放式架構的最新進展
在開放運算計畫全球峰會上,NVIDIA 與合作夥伴宣布多項進展:
- NVIDIA 與超大規模雲端服務供應商共同發布下一代 AI 工廠開放標準,涵蓋 AI 工廠設計標準與電網韌性。
- NVIDIA 為 NVIDIA DSX AI 工廠平台推出全新開源軟體元件。
- Meta 與 NVIDIA 透過 NVIDIA Spectrum-X 乙太網路 SuperNIC 及 Spectrum-6 創新技術,推動開放式 AI 網路技術發展。
- 亞灣超算(Visionbay)推出專為 Vera Rubin 時代打造的 800V 直流電(DC)AI 工廠設計。
- NVIDIA 與思科 (Cisco)宣布超高密度小型可插拔模組(Ultra-Dense Small Form Factor Pluggable,USFP)標準,為業界首款適用於 400 Gb/s 網路架構的模組。
- NVIDIA 與 Google 宣布未來 NVIDIA ConnectX-10 SuperNIC 與 BlueField 資料處理器(DPU)將支援 Falcon 傳輸協定。
NVIDIA 超大規模與高效能運算副總裁 Ian Buck 在座無虛席的活動現場,分享開放式基礎設施如何成為推動全球 AI 工廠擴展規模的關鍵要素。
本次於開放運算計畫全球峰會發布的多項最新消息,突顯NVIDIA 如何將極致協同設計與開放標準相結合,以加速基礎設施部署、改善電力效率,並提高每瓦詞元(tokens-per-watt)效能
NVIDIA 參與 OCP MGX 機櫃設計,推動 Vera Rubin AI 工廠發展🔗
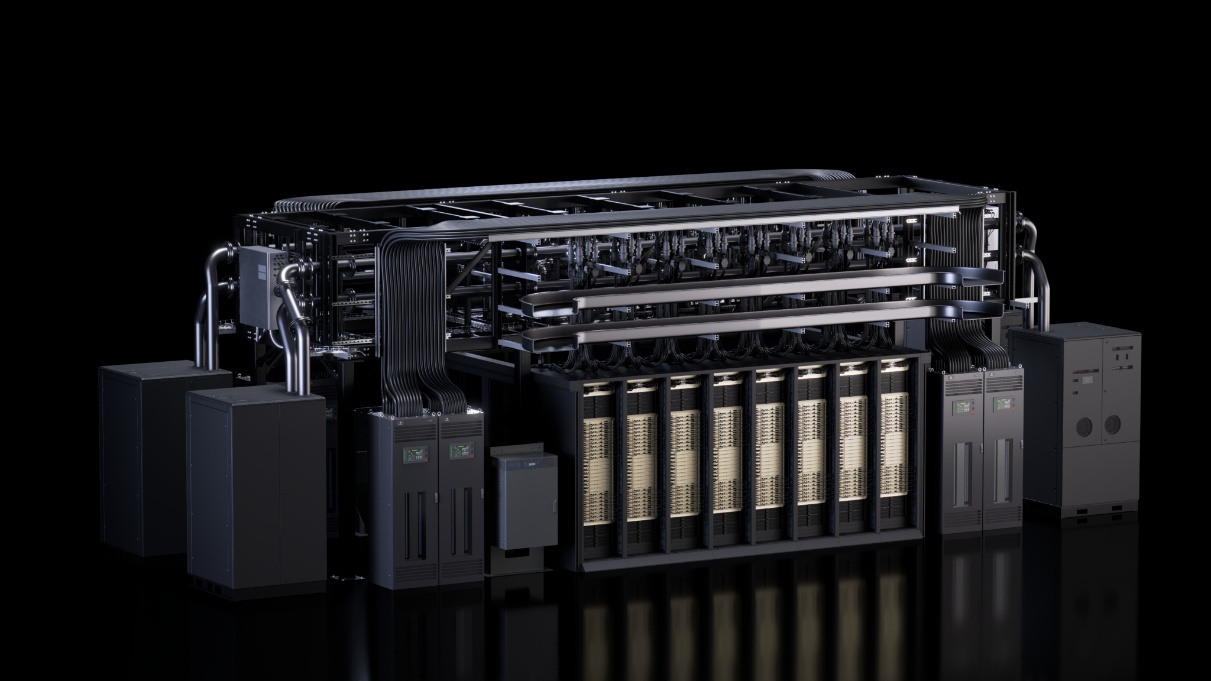
NVIDIA 與產業領導者合作,透過開放運算計畫(Open Compute Project,OCP)的 AI 開放資料中心倡議(Open DC Initiative),共同參與第三代 NVIDIA MGX AI 資料中心參考設計的開發。
這項合作結合液冷快速斷開接頭(MQD)與盲插式液冷快速斷開接頭(MQDB)等開放式液冷技術,將有助於將經過驗證的 AI 工廠設計轉化為產業標準,供其他業者採用、製造並擴展規模。
針對 NVIDIA Vera Rubin AI 工廠,更新後的 MGX 1.2 規格進一步擴充 AI 工廠的開放式架構,納入機櫃級盲插式液冷技術、可互通的機櫃級互連基礎設施,以及專為更高功率 AI 系統設計的液冷式 5,000 安培匯流排。此外,MGX 1.2 也新增原生支援 19 吋設備,以及更高密度的機櫃設計。
MGX 1.2 透過可配置的輸入/輸出(I/O)插槽、無風扇液冷運算托盤、標準化電力與冷卻介面,以及共通基礎設施,進一步提升模組化程度,協助生態系合作夥伴打造可互通的加速運算平台。此規格可縮短組裝、測試及維護時間,簡化製造與現場維護流程,加速基礎設施建置並提升效率。該架構支援最高 250 kW 的機櫃部署,同時提升維護便利性、簡化部署流程與基礎設施再利用。
Vera CPU 機櫃設計規格進一步擴充 NVIDIA MGX 開放式架構,使其應用範圍不再侷限於加速運算,為加速發展的代理 AI 時代打造專屬平台。NVIDIA Vera Rubin NVL72 為大規模訓練與推論的基礎,而 NVIDIA Vera CPU 機櫃則專為支援工具呼叫、協調及沙盒執行而設計,協助 AI 代理即時與應用程式、資料及服務互動。
Vera CPU 機櫃以第三代 NVIDIA MGX 機櫃架構為基礎,延續相同的機櫃級設計原則,將運算、網路、電力與冷卻整合至共通的模組化平台。這項設計讓合作夥伴能夠部署專用基礎設施,同時受惠於共享的生態系、簡化的整合流程,以及為下一代 AI 工廠提供的一致基礎。
NVIDIA 為 DSX AI 工廠平台推出全新開源軟體元件🔗
NVIDIA DSX AI 工廠平台透過極致協同設計,整合運算、網路、電力、冷卻、設施與軟體,協助 AI 工廠以單一最佳化系統運作,在現有基礎設施的限制下,將 AI 產出最大化。DSX OS 是這套整合系統的核心,作為開放式作業層,將 DSX 架構轉化為協調一致、可重複且可規模化的營運模式。
在開放運算計畫全球峰會上,NVIDIA 進一步擴充了 DSX OS ,新增用於網路配置、叢集驗證、機櫃管理及裸機佈建的開源元件:
- NVIDIA Config Manager:自動化執行大規模交換器配置,讓客戶能以極少甚至無須人工介入的方式部署、驗證及維持一致的 AI 工廠網路架構。
- NVIDIA Cluster Readiness Engine:透過模擬真實工作負載,對 GPU 叢集進行壓力測試,在訓練開始前即確保硬體運作正常,協助避免發生代價高昂的工作執行中斷。
- NVIDIA Rack Management Service:提供機櫃硬體抽象化與營運管理解決方案,將機櫃視為獨立的一級管理單位,提升 AI 工廠大規模部署環境中的韌體管理效率。
- Cluster API Provider for NVIDIA Infrastructure Controller:加速裸機部署與租戶導入,將尚未配置的 AI 硬體轉化為可投入正式生產環境的叢集,所需時間從數天縮短至數小時。
這些開源元件結合 NVIDIA 營運 NVIDIA DGX Cloud 的實務經驗,讓雲端服務供應商及軟體合作夥伴能夠將 AI 工廠的功能直接整合至其多租戶平台。
開發者可前往 DSX AI 工廠平台,探索 NVIDIA DSX AI工廠平台全新及現有的開源軟體元件,並參與開發及貢獻。
NVIDIA 與超大規模雲端服務供應商共同發布下一代 AI 工廠開放標準🔗
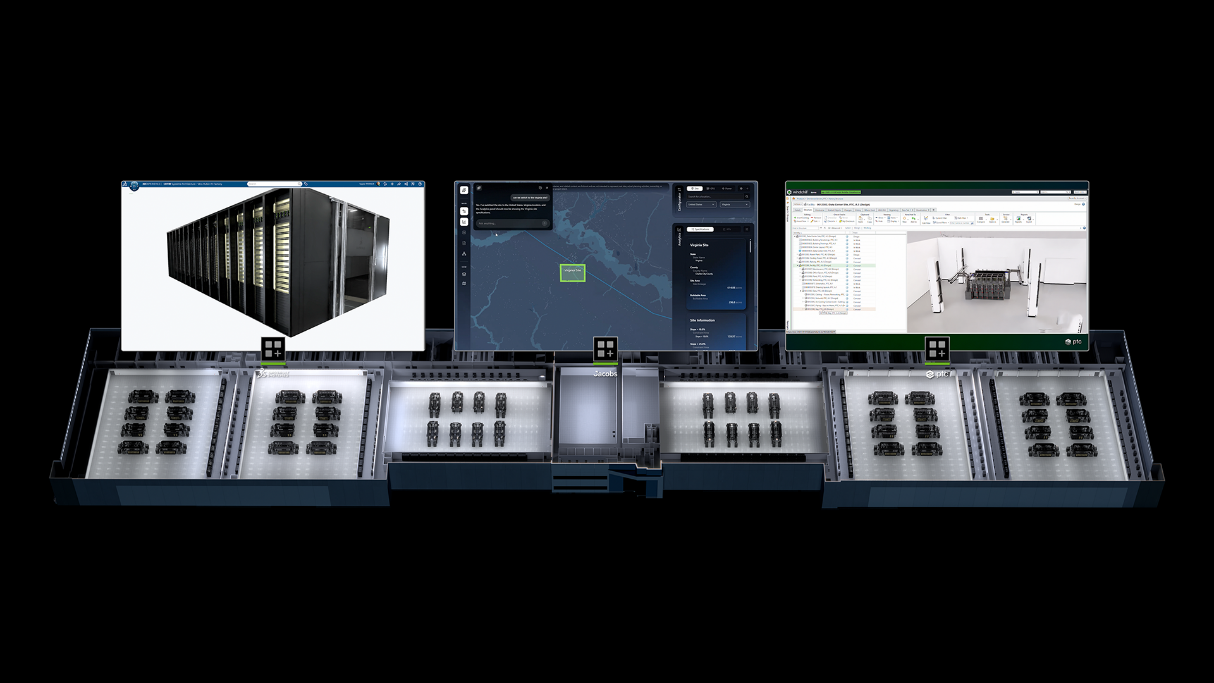
要在全球擴展 AI 基礎設施規模,除了先進硬體,還需要一套可供整個產業共同建置的基礎。
在開放運算計畫全球峰會 (Open Compute Project Global Summit)上,NVIDIA 攜手超微(AMD)、Google 與 Meta 共同發布全新的開放規格,建立產業所需的共同基礎。開放資料中心規格 v0.7 (Open Data Center Specification v0.7)為下一代 AI 工廠的設施設計制定統一藍圖,涵蓋電力架構、冷卻基礎設施及實體配置。
由 Google、Meta、微軟與 NVIDIA 共同發布的 OCP 電網韌性規格 (OCP Grid Resilience Specification),則針對大型 AI 基礎設施在公用電網發生擾動時的運作制定標準,包括維持電網連接、自動回應,並在不到兩秒內恢復至接近滿載的運作狀態。
隨著這些標準正式開放,全球製造商有了可共同遵循的建置依據。設備製造商、資料中心共置服務供應商及資料中心營運商,無須等待個別客戶提供專有規格,即可開始設計、製造及交付全球各地正在興建的 AI 工廠所需之基礎設施。
這些規格與 NVIDIA DSX 參考設計相容,提供經過驗證且可實際部署的實作方案,涵蓋兩項規格中的設施配置、電力架構,以及即時監控與回應電網訊號的軟體。對於建置 Vera Rubin AI 工廠的營運商而言,現在已有明確的實作途徑,可從開放式社群標準落實至實際運作的系統。
如欲了解更多資訊,歡迎參與 NVIDIA 在開放運算計畫全球峰會活動。